转载自公众号:敢敢AUTOHUB
Wan2.2 不是单个模型,而是一组围绕视频生成任务组织的开源模型族。 官方仓库在 2025 年 7 月 28 日开放 T2V、I2V、TI2V 的推理代码和权重,后续又扩展到 S2V 和 Animate。对学习者来说,最容易混淆的是模型名称里的任务缩写:T2V 是文本到视频,I2V 是图像到视频,TI2V 是文本/图像统一到视频,S2V 是语音驱动视频,Animate 则偏角色动画和替换。它们共用很多视频扩散模型思想,但在输入条件、VAE、Transformer 尺寸和推理流程上并不完全一致。
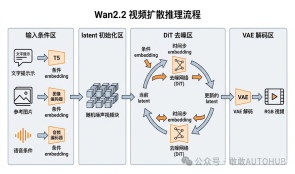
Wan2.2 的核心仍然是扩散式视频生成,不是传统自回归语言模型。 它先把视频压缩到 VAE latent 空间,再在 latent 上用 DiT/Transformer 迭代去噪,最后通过 VAE 解码回 RGB 视频。T2V-A14B 和 I2V-A14B 的最大变化是引入高噪声专家和低噪声专家;TI2V-5B 的最大变化则是使用 Wan2.2-VAE,把视频压缩得更狠,从而让单张消费级显卡也能跑 720P@24fps 的任务。理解这两条线,基本就抓住了 Wan2.2 的主干。
视频扩散可以先理解成“在压缩空间里反复修正一段带噪视频”。 训练时,模型看到真实视频 latent、噪声强度和文本条件,学习如何从带噪 latent 中预测噪声、速度或干净样本方向;推理时,系统从随机噪声开始,按照采样器给出的时间步逐步调用去噪器,每一步都把 latent 推向更像真实视频的方向。由于视频包含时间维、空间维和语义条件,去噪器不能只看一帧,而要同时建模画面内容、运动连续性、主体一致性和提示词约束。
Wan2.2 使用的是视频 latent 上的 Transformer,而不是直接在像素上做扩散。 这点非常关键,因为原始 720P 视频的像素量过大,直接处理会导致注意力计算和显存爆炸。VAE 先把视频压缩成通道数较高但时空尺寸更小的 latent,DiT 再把这些 latent 切成 3D patch token。这样做的代价是模型必须依赖 VAE 保留足够多的细节;收益是 Transformer 可以在较短 token 序列上做全局建模。
T2V-A14B 与 I2V-A14B 是双专家 MoE 版本,TI2V-5B 是高压缩 VAE 支持的密集版本。 从本地配置文件可以看到,T2V-A14B 的实际配置是 dim=5120、num_heads=40、num_layers=40,而不是很多早期解读里常见的 2048/16/32 默认值。WanModel 类的默认参数确实保留了较小配置,但 A14B 权重加载时使用的是任务配置文件,因此正式分析需要以 wan/configs/wan_t2v_A14B.py 和 wan/configs/wan_i2v_A14B.py 为准。
| 模型 | 主要用途 | VAE stride | Transformer 主配置 | 推理步数 | 关键特征 |
|---|---|---|---|---|---|
| T2V-A14B | 文本生成视频 | (4, 8, 8) |
dim=5120, heads=40, layers=40 |
40 | 高噪/低噪双专家,支持 480P/720P |
| I2V-A14B | 图像生成视频 | (4, 8, 8) |
dim=5120, heads=40, layers=40 |
40 | 图像条件输入,双专家边界略不同 |
| TI2V-5B | 文本/图像统一生成视频 | (4, 16, 16) |
dim=3072, heads=24, layers=30 |
50 | 高压缩 Wan2.2-VAE,单卡 4090 可运行 |
官方 对 Wan2.2 的升级点可以归纳为三类:容量、数据和压缩。容量来自高噪声/低噪声双专家设计,训练数据相比 Wan2.1 有更大规模扩展,压缩则来自 TI2V-5B 使用的新 VAE。这里要注意一个写作上的边界:Wan2.2 官方文档把 A14B 称为 MoE,但从代码看它不是 LLM 中常见的 token-level router MoE,而是按去噪时间步切换两个 dense expert;它的“专家化”发生在扩散噪声阶段,而不是每个 token 动态选择专家。
学习 Wan2.2 最稳的方式,是先确认“任务入口”和“真实配置”,再进入模块细节。例如你想跑文本生成视频,就先看 generate.py 如何把 -task t2v-A14B 或 -task ti2v-5B 映射到对应 pipeline;想分析模型规模,就不要只看 WanModel.__init__ 的默认参数,而要看 wan/configs/wan_t2v_A14B.py、wan/configs/wan_i2v_A14B.py 和 wan/configs/wan_ti2v_5B.py。这样做可以避免一个常见误区:拿默认类参数解释正式权重,导致维度、层数、VAE stride 和推理步数都对不上。
WanModel 的 forward 是理解 Wan2.2 的入口。输入 x 是一组视频 latent,每个样本形状近似为 [C, F, H, W];模型先用 Conv3d 做 patch embedding,再记录每个样本的 3D 网格大小 grid_sizes,随后 flatten 成 token 序列。时间步 t 会通过 sinusoidal embedding 和 MLP 变成调制向量,文本上下文通过两层线性层映射到同一个 hidden dimension,最后依次通过多个 WanAttentionBlock,由 Head 输出 patch 内容并 unpatchify 回 latent 视频。
# Wan2.2/wan/modules/model.py 的核心结构简化
self.patch_embedding = nn.Conv3d(
    in_dim, dim, kernel_size=patch_size, stride=patch_size)
self.text_embedding = nn.Sequential(
    nn.Linear(text_dim, dim), nn.GELU(approximate="tanh"), nn.Linear(dim, dim))
self.time_embedding = nn.Sequential(
    nn.Linear(freq_dim, dim), nn.SiLU(), nn.Linear(dim, dim))
self.time_projection = nn.Sequential(
    nn.SiLU(), nn.Linear(dim, dim * 6))
self.blocks = nn.ModuleList([
    WanAttentionBlock(dim, ffn_dim, num_heads, window_size, qk_norm,
                      cross_attn_norm, eps)
    for _ in range(num_layers)
])
self.head = Head(dim, out_dim, patch_size, eps)
这个 pipeline 的关键不是“卷积、注意力、MLP”这些模块名,而是数据形态的变化。视频先被 VAE 压到 latent,再被 3D patch 切成 token;每个 token 同时带有时间位置、空间位置和通道语义。Transformer 做的事情,是在整段视频 token 上估计当前噪声强度下应该如何修正 latent。最后 unpatchify 只是把 token 排列回 [C, F, H, W],真正决定画面细节和运动一致性的,是中间 40 层或 30 层 Transformer 的时空建模能力。
结构上可以把 WanModel.forward 拆成五个连续动作:patch、embed、attend、head、unpatch。 patch 负责把 [C,F,H,W] 的 latent 视频变成 token 序列,embed 负责把时间步和文本条件对齐到模型维度,attend 负责在 self-attention 中建模视频内部关系并在 cross-attention 中吸收条件,head 负责把 hidden token 投影回 patch 内容,unpatch 则把 patch 内容重新拼回 latent 视频。优化时也可以沿着这五步定位问题:shape 错多半在 patch/unpatch,语义不跟 prompt 多半在条件 embedding 或 CFG,运动不稳多半在 attention、RoPE 或训练数据覆盖。
# forward 中从 latent 到 token,再从 token 回 latent 的主流程
x = [self.patch_embedding(u.unsqueeze(0)) for u in x]
grid_sizes = torch.stack(
    [torch.tensor(u.shape[2:], dtype=torch.long) for u in x])
x = [u.flatten(2).transpose(1, 2) for u in x]
seq_lens = torch.tensor([u.size(1) for u in x], dtype=torch.long)

for block in self.blocks:
    x = block(x, **kwargs)

x = self.head(x, e)
x = self.unpatchify(x, grid_sizes)Wan2.2 的 patch 不是只切图像,而是切视频 latent 的时间、空间三维结构。默认 patch_size=(1, 2, 2) 表示时间维不合并,空间维每 2x2 latent 网格合成一个 token。对于 T2V-A14B,VAE 已经把原视频压到 (4, 8, 8) 的时空 stride,因此 DiT 再做 (1, 2, 2) patch 后,空间 token 进一步减少一半;对于 TI2V-5B,VAE stride 已经是 (4, 16, 16),再配合 DiT patch 后,总体空间压缩会更高。
3D patch 的意义是让 Transformer 的每个 token 代表一个局部时空块,而不是一个像素或单帧区域。这会显著减少序列长度,使全局 attention 有可能在 720P 视频上运行。缺点是 patch 过大时会损失细粒度运动和纹理,因此 Wan2.2 在 T2V/I2V 和 TI2V 上采用了不同的 VAE 压缩策略:A14B 追求更强质量,TI2V-5B 追求更高效率。学习代码时不要只看patch_size,还要把它和vae_stride合起来理解。
扩散模型中的时间步不是普通的位置编码,而是当前噪声强度的控制信号。Wan2.2 先用 sinusoidal_embedding_1d 把时间步变成频率特征,再经过 time_embedding MLP 得到 hidden 向量,最后用 time_projection 输出 6 * dim。这六组向量会在每个 WanAttentionBlock 里拆成 shift, scale, gate, shift2, scale2, gate2,分别调制 self-attention 和 FFN 的归一化输入及残差门控。
# 时间步被投影成 6 组调制参数
e = self.time_embedding(
    sinusoidal_embedding_1d(self.freq_dim, t)
        .unflatten(0, (bt, seq_len)).float()
)
e0 = self.time_projection(e).unflatten(2, (6, self.dim))
这类结构常被称为 AdaLN-Zero 风格调制,适合扩散 Transformer。直观理解是:同一段 noisy latent,在高噪声阶段和低噪声阶段需要不同的处理方式;时间步调制相当于告诉每一层“现在应该更关注大轮廓,还是更关注纹理和细节”。Wan2.2 又在 A14B 层面引入高噪/低噪专家,因此时间信息同时影响“选哪个大模型”和“每层内部如何调制”。
每个 WanAttentionBlock 的顺序是 self-attention、cross-attention 和 FFN。self-attention 建模视频 token 之间的时空关系,cross-attention 把文本条件注入视觉 token,FFN 对每个 token 做非线性变换。代码中 norm1、norm2 使用强制 fp32 的 LayerNorm,Q/K 可选 RMSNorm,attention 使用封装后的 flash_attention。这套结构和很多 DiT 类模型相似,但 Wan 的重点是 3D RoPE、视频长度处理和扩散时间调制。
# WanAttentionBlock 的核心逻辑简化
e = (self.modulation.unsqueeze(0) + e).chunk(6, dim=2)

y = self.self_attn(
    self.norm1(x).float() * (1 + e[1].squeeze(2)) + e[0].squeeze(2),
    seq_lens, grid_sizes, freqs)
x = x + y * e[2].squeeze(2)

x = x + self.cross_attn(self.norm3(x), context, context_lens)
y = self.ffn(
    self.norm2(x).float() * (1 + e[4].squeeze(2)) + e[3].squeeze(2))
x = x + y * e[5].squeeze(2)
这里的门控残差值得特别注意。普通 Transformer 通常直接 x + attention(x),而 Wan2.2 会用时间步生成的 gate 控制残差强度。扩散模型从纯噪声到清晰样本的每一步都在不同分布上工作,如果所有时间步共享同样的残差路径,很容易出现训练不稳定或不同噪声阶段能力冲突。AdaLN-Zero 的价值就在于把“噪声阶段”显式注入每一层,使同一个 block 可以在多种 denoising regime 下工作。
视频 token 需要同时知道自己处于第几帧、画面的哪一行、哪一列。Wan2.2 的 rope_apply 会把频率分成时间、高度、宽度三段,然后 broadcast 到 (F, H, W) 网格中,再把 Q/K 转成 complex 表示进行旋转。这样 self-attention 在比较 token 时不仅看到语义向量,还能感知三维相对位置关系。对于视频生成,这比单纯的一维位置编码更自然,因为运动一致性依赖时间维,构图和纹理依赖空间维。
# 3D RoPE 的关键思想:把频率拆成 t/h/w 三段后拼回每个 token
freqs = freqs.split([c - 2 * (c // 3), c // 3, c // 3], dim=1)
freqs_i = torch.cat([
    freqs[0][:f].view(f, 1, 1, -1).expand(f, h, w, -1),
    freqs[1][:h].view(1, h, 1, -1).expand(f, h, w, -1),
    freqs[2][:w].view(1, 1, w, -1).expand(f, h, w, -1)
], dim=-1).reshape(seq_len, 1, -1)
x_i = torch.view_as_real(x_i * freqs_i).flatten(2)
RoPE 只作用在 Q/K 上,不直接改 V。这符合注意力机制的定位逻辑:位置影响“谁和谁相似、谁应该关注谁”,而 value 仍然携带内容信息。Wan2.2 在初始化时预计算长度 1024 的频率表,并在 forward 中根据每个样本的 grid_sizes 切片使用,避免每次为不同视频动态生成完整频率网格。这是一个很典型的工程优化:模型保持支持可变视频形状,但高频路径尽量复用预计算张量。
Wan2.2 A14B 的 MoE 可以理解为“按去噪阶段切换两个 dense DiT”。高噪声阶段,latent 还接近随机噪声,模型主要需要决定整体布局、主体关系和大运动方向;低噪声阶段,latent 已经出现可辨识结构,模型更需要修正纹理、边缘、局部动作和语义细节。官方说法是每个专家约 14B 参数,总参数约 27B,但每个采样步只激活一个 14B 专家,因此计算量接近单个 14B 模型。
从代码看,专家切换发生在 WanT2V._prepare_model_for_timestep。 T2V 配置里 boundary=0.875,推理时会乘以训练总时间步得到阈值;如果当前时间步大于等于阈值,就使用 high_noise_model,否则使用 low_noise_model。这是一种硬路由,没有 token-level router,也没有 top-k expert 选择。它更像 diffusion timestep expert routing,而不是大语言模型里每层 FFN 的稀疏 MoE。
# Wan2.2/wan/text2video.py 的专家选择逻辑简化
def _prepare_model_for_timestep(self, t, boundary, offload_model):
    if t.item() >= boundary:
        required_model_name = "high_noise_model"
        offload_model_name = "low_noise_model"
    else:
        required_model_name = "low_noise_model"
        offload_model_name = "high_noise_model"

    if offload_model or self.init_on_cpu:
        if next(getattr(self, offload_model_name).parameters()).device.type == "cuda":
            getattr(self, offload_model_name).to("cpu")
        if next(getattr(self, required_model_name).parameters()).device.type == "cpu":
            getattr(self, required_model_name).to(self.device)
    return getattr(self, required_model_name)
为什么这仍然可以被称为 MoE,争议点也正在这里。如果按“多个专家分别负责不同输入区域或 token”的狭义定义,Wan2.2 的 A14B 确实不像 LLM MoE 或 DiffMoE 那样细粒度;如果按“同一任务中存在多个专家子模型,由路由策略选择当前激活专家”的广义定义,它又确实满足 MoE 的基本思想。更严谨的表述是:Wan2.2 采用了面向扩散去噪阶段的双专家硬路由,而不是 token 级稀疏专家路由。
Wan2.2 的采样循环每一步会分别跑条件分支和无条件分支,再做 classifier-free guidance。代码中 arg_c 使用正向 prompt 的文本 embedding,arg_null 使用负向 prompt 或空条件文本 embedding。模型先预测 noise_pred_cond,再预测 noise_pred_uncond,最后按 noise_pred_uncond + scale * (cond - uncond) 合成最终预测。T2V-A14B 还允许低噪声和高噪声阶段使用不同 CFG scale,例如配置中 (3.0, 4.0) 表示低噪 scale 为 3.0,高噪 scale 为 4.0。
boundary = self.boundary * self.num_train_timesteps

for _, t in enumerate(tqdm(timesteps)):
    timestep = torch.stack([t])
    model = self._prepare_model_for_timestep(t, boundary, offload_model)
    sample_guide_scale = guide_scale[1] if t.item() >= boundary else guide_scale[0]

    noise_pred_cond = model(latent_model_input, t=timestep, **arg_c)[0]
    noise_pred_uncond = model(latent_model_input, t=timestep, **arg_null)[0]
    noise_pred = noise_pred_uncond + sample_guide_scale * (
        noise_pred_cond - noise_pred_uncond)
    latents = [sample_scheduler.step(...)[0].squeeze(0)]
这段代码说明 Wan2.2 的“推理成本几乎不变”有一个前提:每步只让一个专家参与。如果显存足够,可以把两个专家都留在 GPU 上以减少 CPU/GPU 来回搬运;如果显存不足,offload_model=True 会把暂时不用的专家卸载到 CPU。这样可以降低峰值显存,但会增加 PCIe 传输和等待时间。实际部署时,A14B 更适合 80GB 级显卡或多卡并行,TI2V-5B 才是普通消费级单卡更现实的入口。
TI2V-5B 的关键不只是 Transformer 从 14B 变成 5B,而是 Wan2.2-VAE 把视频 latent 压得更小。配置文件里 ti2v_5B.vae_stride = (4, 16, 16),表示 VAE 输出相对于原视频在时间上压缩 4 倍、空间上压缩 16 倍。随后 DiT 的 patch_size=(1, 2, 2) 又在 latent 网格上做空间 patch,因此官方称加上 patchification 后总压缩可达到 4x32x32。这直接减少 token 数量,是 TI2V-5B 能在 RTX 4090 这类显卡上运行的根本原因之一。
从 vae2_2.py 看,压缩来自 patchify、残差下采样和因果 3D 卷积的组合。patchify(x, patch_size=2) 先把空间 2x2 像素块并入通道维,随后 Down_ResidualBlock 根据 temperal_downsample 和 down_flag 决定是否对时间和空间下采样。本地仓库当前 Wan2_2_VAE wrapper 默认传入 temperal_downsample=[False, True, True],意味着下采样 block 中有两次时间下采样,空间下采样发生在前三个 block;结论仍然是时间 x4、空间 x16 的 VAE 压缩。
# Wan2.2/wan/modules/vae2_2.py 中的空间 patchify
def patchify(x, patch_size):
    if patch_size == 1:
        return x
    if x.dim() == 5:
        x = rearrange(
            x,
            "b c f (h q) (w r) -> b (c r q) f h w",
            q=patch_size,
            r=patch_size,
        )
    return x

# Down_ResidualBlock 中的时间/空间下采样入口
self.avg_shortcut = AvgDown3D(
    in_dim,
    out_dim,
    factor_t=2 if temperal_downsample else 1,
    factor_s=2 if down_flag else 1,
)
高压缩 VAE 的代价是 DiT 看到的 latent 更“粗”,因此必须依赖更强的 VAE 重建能力和更好的时空先验。如果 VAE 压缩过头,模型会更容易出现小物体糊掉、纹理不稳定、边缘抖动等问题;如果压缩不足,token 序列过长,推理速度和显存就会失控。Wan2.2-VAE 的意义在于把这个工程平衡点往高分辨率侧推了一步,让 720P@24fps 的开源视频生成更接近普通开发者可运行的范围。
Wan2.2 生成一段固定长度视频时,通常是把整段 latent 作为一个序列反复去噪。在 WanSelfAttention.forward 中,Q/K/V 来自同一个 token 序列,flash_attention 接收 RoPE 后的 Q/K、V、真实长度和 window_size。T2V-A14B 配置里 window_size=(-1, -1),表示全局 attention;代码中没有时间维 causal mask,也没有限制某一帧只能看过去帧。因此,在同一个 denoising step 内,一个 token 可以和同段视频中的过去、当前、未来 token 建立注意力关系。
# self-attention 没有显式 causal mask,默认窗口为全局
x = flash_attention(
    q=rope_apply(q, grid_sizes, freqs),
    k=rope_apply(k, grid_sizes, freqs),
    v=v,
    k_lens=seq_lens,
    window_size=self.window_size)
这就是很多 WAM 论文讨论的“bidirectional diffusion”背景。在普通视频生成里,双向依赖是优势:模型知道整段视频的起点和终点,能更好保持主体一致、镜头运动和全局构图。问题出现在世界模型和机器人控制场景:真实环境不会提前给你未来帧,机器人只能根据历史观察和当前动作预测未来。如果一个模型训练和推理都依赖未来 token,它就很难直接作为在线世界模型使用,因为它不满足因果性。
“去除双向去噪”容易被误解成“不再使用扩散”。更准确的说法是:保留扩散模型强大的视频生成先验,但把时间依赖从全片双向 attention 改成因果或分块自回归。也就是说,模型在生成第 k 个未来片段时,只能看历史观测、历史动作、当前计划动作和已经生成的片段,不能看尚未生成的未来片段。扩散仍然可以在当前 chunk 内迭代去噪,但 chunk 与 chunk 之间必须按时间向前滚动。
# 普通整段视频扩散:每一步都处理整段视频 latent
latents = randn(shape=[C, F, H, W])
for t in timesteps:
    pred = denoiser(latents, text, t)  # 同时看整段 F 帧
    latents = solver.step(pred, t, latents)

# 自回归世界模型:按未来片段逐段生成
history = encode_observed_frames(obs)
for chunk_id in range(num_future_chunks):
    z = randn(shape=[C, chunk_F, H, W])
    action_cond = actions[chunk_id]
    for t in timesteps:
        pred = causal_denoiser(z, history, action_cond, t)
        z = solver.step(pred, t, z)
    history = append(history, z)
这类改造的本质是把视频生成模型变成“可交互动力学模型”。普通 Wan2.2 主要回答“给定提示词,生成一段看起来合理的视频”;WAM 需要回答“给定当前观察和候选动作,未来世界会怎样变化,以及下一步应该采取什么动作”。因此,WAM 不只需要画面质量,还需要动作可控性、因果一致性、闭环反馈和低延迟。Vid2World 提到的 video diffusion causalization,DreamZero 的 autoregressive video diffusion control,以及 LingBot-VA 的 autoregressive diffusion framework,都是围绕这个问题展开。
WAM 是 World Action Model,即把世界预测和动作生成放到同一个框架里。VLA 模型通常从图像和语言直接输出动作,像一个强大的反应式策略;WAM 则显式建模“动作会如何改变未来视觉状态”,目标更接近未来状态和动作的联合分布。2026 年的 WAM survey 把这个方向概括为:统一预测式状态建模和动作生成,目标不是只预测动作,而是同时面向未来状态与动作。
这个区别在机器人场景里非常重要。如果桌面上有一个杯子,VLA 可以根据当前图像判断“伸手抓取”;但当杯子被遮挡、目标需要绕障、或者任务需要长时序计划时,只看当前观察到动作的映射就不够了。WAM 希望模型先在内部“想象”动作后的短期未来,再用这个未来预测帮助选择动作。对视频生成模型来说,这意味着要把文本条件换成或扩展为动作条件、机器人状态条件、历史视频条件和任务语言条件。
Wan2.2 不是开箱即用的机器人 WAM,但它是很典型的可复用视频先验。它已经学到了大量关于物体、场景、运动、镜头和物理外观的统计规律,这些规律对世界模型很有价值。要把它改造成 WAM,通常需要做四件事:第一,把图像/视频历史作为条件输入;第二,引入动作 token 或低层控制信号;第三,把双向时序建模改成因果建模;第四,增加动作预测头或把动作作为联合生成对象。
一个较现实的技术路线是“预训练视频扩散骨干 + 因果化微调 + 动作条件对齐”。Vid2World 的思路是系统探索如何把预训练视频扩散模型改造成可自回归生成的交互世界模型,并加入 causal action guidance 来增强动作可控性。DreamZero 则把 WAM 建在预训练视频扩散骨干之上,同时建模视频和动作,并报告了 14B 自回归视频扩散模型可以通过系统优化达到实时闭环控制。Fast-WAM 进一步提出一个反问题:测试时是否一定要显式生成未来视频,还是视频建模主要在训练阶段提升表示。
自回归视频生成通常不是一帧一帧生成,而是按 chunk 生成。原因很简单:逐帧生成会很慢,并且帧间一致性难以保证;整段双向生成又不满足在线因果。折中方案是每次生成未来几帧或几十帧,把已经观测或已经生成的历史作为条件,再预测下一个 chunk。这个 chunk 内部可以继续使用扩散迭代,chunk 之间则按时间自回归展开。对机器人来说,每个 chunk 往往还要绑定动作序列、末端位姿、关节状态或离散 action token。
训练目标也要跟着变化。普通视频扩散训练会随机加噪整段视频,让模型预测整段视频的去噪方向;WAM 的训练则需要让模型在只能看到历史和动作的条件下预测未来。常见做法包括 causal attention mask、历史帧前缀条件、未来 chunk denoising、动作条件 cross-attention、动作预测辅助 loss,以及用真实环境反馈做 closed-loop rollout。这样训练出来的模型不再只是“会画视频”,而是逐渐学到“动作如何改变视觉状态”。
第一条路线是视频扩散因果化。这条路线以 Vid2World 这类工作为代表,核心问题是如何最大化复用现有视频扩散模型的视觉质量,同时消除未来信息泄漏,使它可以在交互式环境中自回归滚动。工程上通常会涉及 temporal causal mask、KV cache、chunk conditioning、动作条件注入和采样加速。它的优势是可以继承互联网视频预训练带来的泛化能力,难点是动作可控性和低延迟。
第二条路线是视频和动作联合建模。DreamZero、LingBot-VA 这类工作更强调把 action 放进模型本体,让模型同时学习未来视觉和动作策略。DreamZero 的公开摘要强调 WAM 通过预测未来世界状态和动作来学习物理动力学,并报告在真实机器人上相对 VLA 有更好的泛化;LingBot-VA 则提出自回归扩散框架,同时学习帧预测和策略执行,并使用共享 latent、Mixture-of-Transformers 和闭环 rollout。这个方向更接近“策略模型 + 世界模型”的融合。
第三条路线是把视频预测作为训练信号,而不是每次测试都显式想象未来。Fast-WAM 的问题意识很直接:如果每次控制都跑多步视频扩散,延迟会很高;是否可以保留训练时的视频 co-training,让模型学到更好的世界表示,但在测试时跳过未来视频生成,直接输出动作。它报告的结论是,去掉测试时显式 future imagination 后仍可保持竞争力,而移除视频 co-training 会造成更大下降。这说明 WAM 的价值可能不只在“生成未来画面”,也在于训练阶段形成更强的物理表示。
Wan2.2 的 MoE 是按噪声阶段切模型,DiffMoE 更接近动态计算分配。DiffMoE 关注扩散过程中输入条件、噪声水平和样本复杂度的异质性,引入全局 token pool 和 capacity predictor,让专家根据噪声水平与复杂度动态分配计算资源。相比之下,Wan2.2 的公开代码里没有 token-level expert router,也没有每层动态 capacity;它的路线更朴素,但工程上更直接,容易用两个现有 dense 模型组成可部署系统。
因此比较二者时,不应简单说谁更“真正 MoE”。Wan2.2 的目标是视频生成质量、训练收敛和推理成本之间的工程平衡;DiffMoE 的目标是探索扩散模型内部更细粒度的专家化机制。对开发者来说,Wan2.2 的可学习点在于:扩散模型不一定只能做一个全阶段 denoiser,高噪与低噪确实可能需要不同容量和偏好的专家。对研究者来说,下一步自然会追问:能否把 Wan2.2 的阶段专家继续细化成层级、token 级或动作条件专家。
如果要把 Wan2.2 类视频模型改造成 WAM,不要一开始就同时改 VAE、DiT、采样器和策略头,而应该按“条件扩展 → 时序因果化 → 动作联合建模 → 闭环验证”的顺序推进。第一步只做条件扩展,把历史帧和动作序列编码成 cross-attention 条件,先验证模型能否根据不同动作生成不同未来;第二步加入 temporal causal mask 或 chunk 级自回归,让未来片段不能反向影响历史;第三步增加动作预测头或联合生成动作 token,让模型不只预测画面,也能给出下一步控制候选;第四步用真实或仿真环境做 closed-loop rollout,评估长期漂移、碰撞率、任务成功率和延迟。
运行 Wan2.2 可以按“环境、权重、任务、显存策略”四步理解。先克隆官方仓库并安装依赖,确保 PyTorch 版本满足要求;再下载对应任务权重,例如 Wan-AI/Wan2.2-T2V-A14B 或 Wan-AI/Wan2.2-TI2V-5B;随后按任务选择 -task、-size、-ckpt_dir 和输入条件;最后根据显存决定是否打开 -offload_model True、-convert_model_dtype、-t5_cpu,以及是否使用多卡 FSDP 和 Ulysses。
git clone
cd Wan2.2
pip install -r requirements.txt

pip install "huggingface_hub[cli]"
huggingface-cli download Wan-AI/Wan2.2-TI2V-5B --local-dir ./Wan2.2-TI2V-5B
如果只是学习和试跑,建议从 TI2V-5B 开始,而不是直接上 A14B。官方 README 给出的单卡 TI2V-5B 命令可以在 24GB 级显卡上运行,代价是需要 offload、dtype 转换和 T5 CPU 放置,速度不会像多卡服务器那样快。A14B 的单卡运行通常需要 80GB VRAM 级别,普通开发者更现实的方式是多卡、云端或使用社区量化/加速方案。先用 TI2V-5B 跑通全流程,再研究 A14B 的 MoE 结构,会更符合学习曲线。
# 单卡 TI2V-5B 文本到视频
python generate.py
  --task ti2v-5B
  --size 1280*704
  --ckpt_dir ./Wan2.2-TI2V-5B
  --offload_model True
  --convert_model_dtype
  --t5_cpu
--prompt "A quiet laboratory table, robotic arm sorting small metal parts with precise motion, cinematic lighting"总体来看,Wan2.2 可以作为理解现代视频扩散模型和 WAM 世界模型改造路线的一个很好入口。它的主干逻辑是先用 VAE 把视频压到 latent 空间,再通过 3D PatchEmbedding、TimeEmbedding / AdaLN-Zero、WanAttentionBlock、3D RoPE 和采样循环完成时空去噪;A14B 的高噪/低噪双专家体现了扩散模型按噪声阶段分工的工程思路,TI2V-5B 的高压缩 VAE 则体现了面向普通显卡部署的效率取舍。进一步往 WAM 方向看,Wan2.2 本身还不是因果世界模型,但它提供了可复用的视频生成先验;真正的改造重点在于引入历史观察和动作条件、消除未来信息泄漏、支持 chunk 级自回归预测,并最终在闭环机器人任务中验证动作敏感性、因果一致性和实时性。
1. Wan2.2 官方仓库:https://github.com/Wan-Video/Wan2.22. Wan2.2 官方 README,本地路径:Wan2.2/README.md
3. Wan: Open and Advanced Large-Scale Video Generative Models,arXiv:2503.20314:https://arxiv.org/abs/2503.20314
4. Wan2.2 T2V-A14B 配置,本地路径:Wan2.2/wan/configs/wan_t2v_A14B.py
5. Wan2.2 TI2V-5B 配置,本地路径:Wan2.2/wan/configs/wan_ti2v_5B.py
6. WanModel 核心实现,本地路径:Wan2.2/wan/modules/model.py
7. Wan2.2-VAE 核心实现,本地路径:Wan2.2/wan/modules/vae2_2.py
8. Vid2World: Causalizing Video Diffusion Models for World Models,arXiv:2505.14357:https://arxiv.org/abs/2505.14357
9. DreamZero: World Action Models are Zero-shot Policies,arXiv:2602.15922:https://arxiv.org/abs/2602.15922
10. Fast-WAM: Do World Action Models Need Test-time Future Imagination?,arXiv:2603.16666:https://arxiv.org/abs/2603.16666
11. LingBot-VA: Learning to Navigate Long-Horizon Manipulation via Visual Autoregressive World Model,arXiv:2601.21998:https://arxiv.org/abs/2601.21998
12. World Action Models: The Next Frontier in Embodied AI,arXiv:2605.12090:https://arxiv.org/abs/2605.12090
13. DiffMoE: Dynamic Token Selection for Scalable Diffusion Transformers,arXiv:2503.14487:https://arxiv.org/abs/2503.14487
(来源:与非网)